
ToolGate:让视觉语言智能体学会"少调用工具"
近日,我们的工作 ToolGate: Token-Efficient Pre-Call Control for Tool-Augmented Vision-Language Agents 被 EMNLP 2026 Main Conference 录用。
现在的视觉语言智能体(VLM Agent)可以调用 OCR、目标检测、图像分割、裁剪和深度估计等外部工具来获取额外的视觉信息。但工具并不是调用得越多越好:每次调用都会增加 Token、计算和时间成本,错误的工具结果还可能干扰模型原本正确的判断。
很多工具调用其实没有必要
我们分析了五个视觉语言基准上的 15,782 次工具调用。只有 11.8% 的调用会让模型的即时判断从错误变为正确,9.9% 反而会让正确判断变错,其余大多数调用不会立即改变模型的答案。
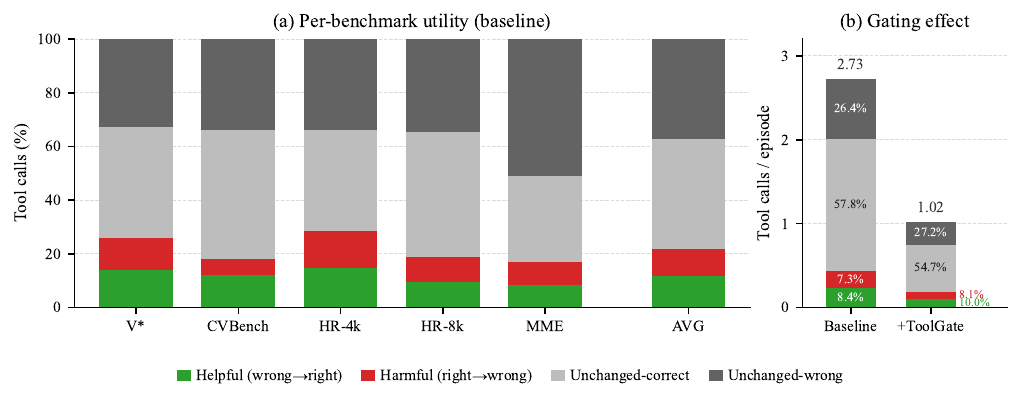
这说明,问题不仅是让 Agent "会用工具",还要让它知道:这一次工具调用到底值不值得执行?
ToolGate:在工具真正运行之前先判断一次
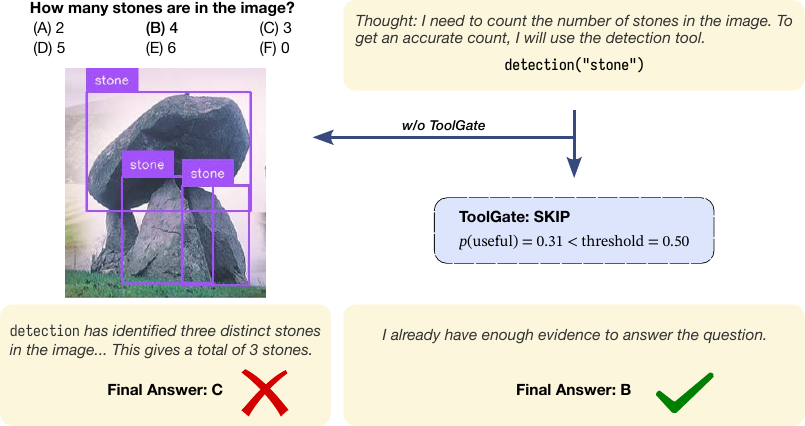
为此,我们提出 ToolGate。当 VLM Agent 已经提出一个工具调用后,ToolGate 会在工具真正执行之前进行一次轻量级判断,决定执行还是跳过,从而避免不必要的工具输出进入上下文。
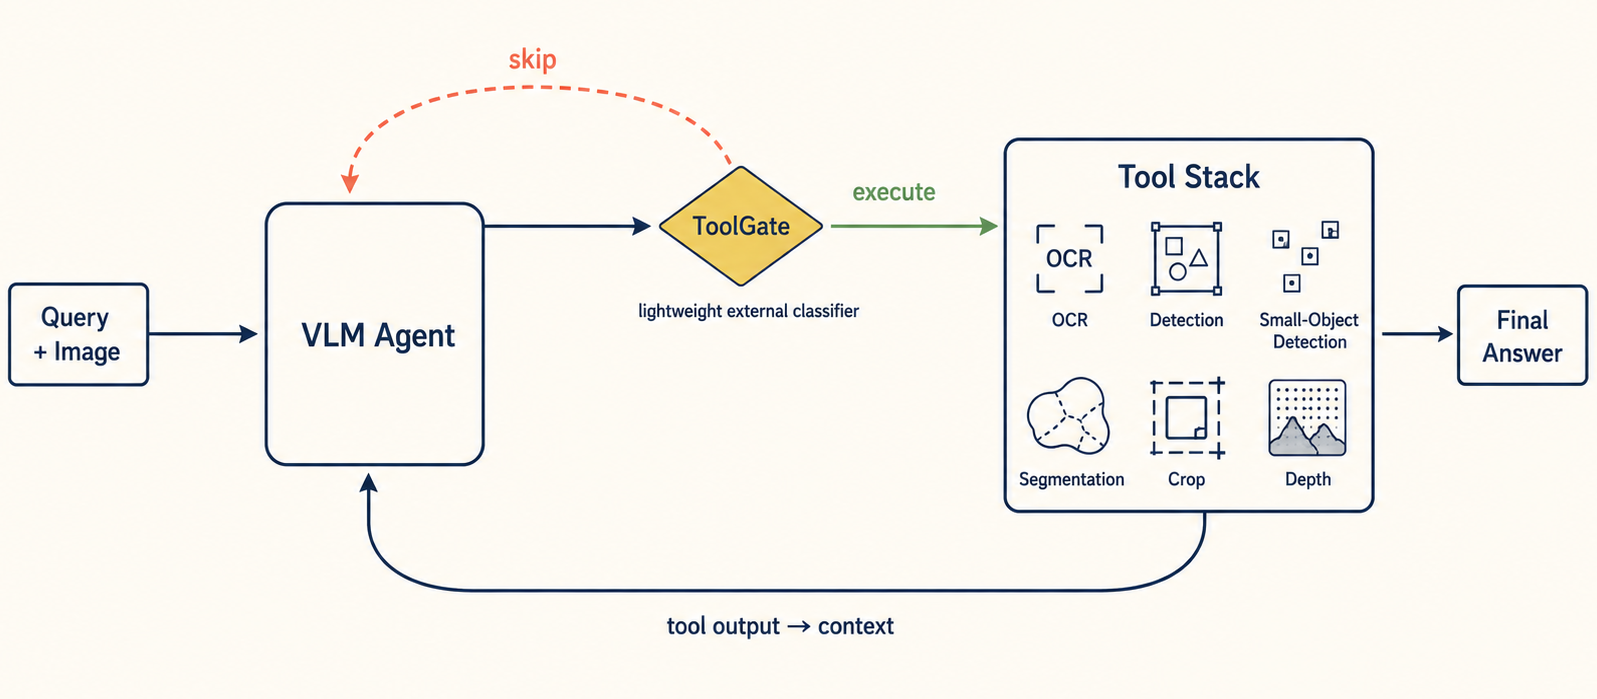
ToolGate 是一个独立于 VLM 和工具栈的轻量级控制器,不需要修改基础模型或视觉工具本身。
更少的调用,更低的成本
在两个不同规模的 Qwen3-VL 模型上,ToolGate 都能显著减少不必要的工具调用,将 Token 成本降低到原来的 64%–69%,同时基本保持模型的回答准确率。更重要的是,即使 ToolGate 完全没有使用测试任务的数据进行训练,这种节省效果依然成立;而当使用同类任务的数据进行训练时,在 Qwen3-VL-30B 上,平均准确率还进一步提升了 1.65 个百分点。
这项工作的核心想法很简单:
AI Agent 的下一步,不只是拥有更多工具,而是学会主动管理信息:何时获取、获取什么,以及何时停止
示例
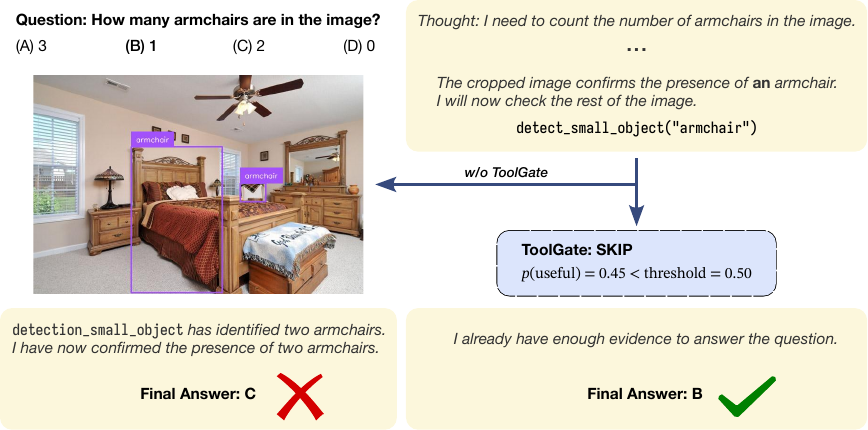
下面是论文中的三个定性案例,展示 ToolGate 如何在具体视觉任务中决定是否执行工具调用。
(a)
(b)
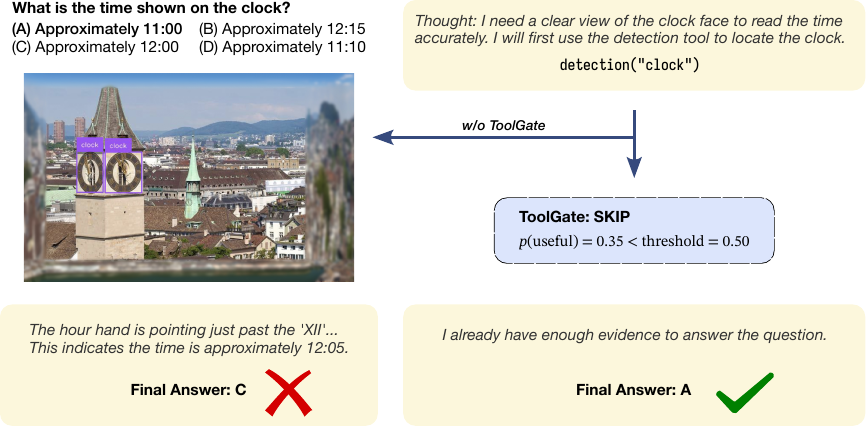
(c)
Paper: ToolGate: Token-Efficient Pre-Call Control for Tool-Augmented Vision-Language Agents
Venue: EMNLP 2026 Main Conference
Code: https://github.com/iamlilAJ/toolgate